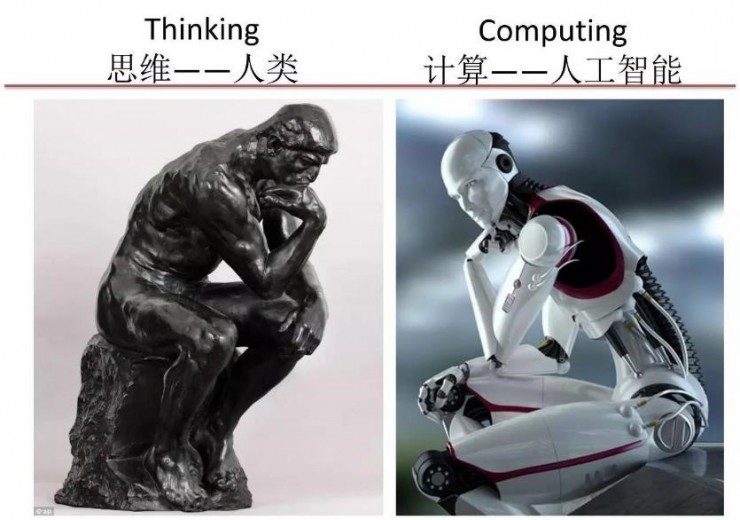
数据与知识的共舞 大数据驱动与专家知识引导下的人工智能基础理论前沿
人工智能走过七十余年历程,其理论根基正在经历一次深刻的范式重构。传统AI沿着两条独立路径演进:一条是以数据驱动的机器学习,依赖统计规律从海量样本中提取模式;另一条是以知识驱动的符号推理,依靠专家经验构建逻辑规则体系。当大模型展现出惊人能力的同时也暴露出幻觉频发、逻辑脆弱、可解释性不足等瓶颈时,学界逐渐形成一个共识——单一范式已触及天花板,人工智能基础理论的下一程,在于大数据与专家知识的深度融合。
一、两条路径的成就与困境
数据驱动范式在感知任务上取得了压倒性成功。深度学习的核心假设是:足够大的模型加上足够多的数据,可以逼近任意复杂函数。这一假设在图像识别、语音处理、自然语言生成等领域屡试不爽。但它的代价同样显著——模型学到的是相关性而非因果性,面对分布外样本时脆弱不堪,且训练成本呈指数级增长,数据边际收益递减的迹象已经显现。
知识驱动范式则走了一条截然不同的路。专家系统、本体论、逻辑程序在医疗诊断、法律推理等需要严谨性的领域仍然不可替代,因为它们提供的是可验证、可追溯的推理链条。但知识获取瓶颈始终未能突破:手工编码规则的成本极高,且难以覆盖真实世界的模糊性与开放性。
两条路径的困境其实指向同一个问题——如何让机器同时具备数据驱动的泛化能力和知识驱动的推理能力?
二、融合的理论支点
若干理论方向的突破正在为这一融合提供数学基础。
神经符号计算是最直接的融合尝试。其核心思想是将神经网络的表示学习能力与符号系统的逻辑推演能力结合起来,例如用神经网络从数据中提取谓词和关系,再将它们送入符号推理引擎进行演绎。这不只是工程拼凑——它背后有范畴论和代数逻辑的理论支撑,试图为“学习”与“推理”建立统一的数学语言。
因果表示学习则从另一个角度切入。Pearl的因果阶梯理论指出,纯粹的统计学习只能停留在“关联”层面,无法回答“干预”和“反事实”问题。因果表示学习试图从数据中发现因果结构,并将专家知识以因果图的形式注入模型,使AI具备真正的因果推理能力而非仅仅模式匹配。这是一个从“看到什么”到“理解为什么”的跃迁。
知识增强的预训练理论也在快速发展。大语言模型本质上是在做概率性的序列预测,但如果能在预训练阶段就将结构化知识以某种形式嵌入表示空间——无论是通过知识图谱的对比学习,还是通过逻辑约束的正则化——模型就有可能在不牺牲泛化能力的前提下,获得更稳定的推理能力。这一方向的关键理论问题在于:知识与数据的融合应该在哪个层级发生?是输入层、表示层还是推理层?
三、大数据的角色再审视
值得注意的是,融合范式并非要否定大数据的价值。恰恰相反,大数据在新的理论框架中承担着不同于以往的职能。如果说传统深度学习用数据来“拟合函数”,那么融合范式用数据来“发现结构”——发现变量之间的因果方向、发现知识图谱中缺失的链接、发现符号规则的概率权重。数据从目的变成了手段,从终点变成了起点。
四、通向通用智能的理论路线
将这些方向整合起来,一幅更完整的理论图景浮现出来:AI系统应当具备三层结构——底层是数据驱动的感知与表示,中层是知识引导的推理与规划,顶层是因果驱动的解释与决策。三层之间不是简单的串联,而是双向交互:数据自下而上地修正和扩展知识,知识自上而下地约束和引导学习。
这意味着一场深刻的范式转换:从“更大数据、更大模型”的规模竞赛,转向“更优结构、更强推理”的理论深(a)化。规模仍然重要,但单靠规模已不足以实现从“鹦鹉学舌”到“真正理解”的跨越。当前大模型最大的短板——逻辑推理的脆弱性、事实一致性、对新颖情境的适应能力——恰恰是大数据和专家知识融合最有希望取得突破的方向。
未来的AI基础理论,必然是在统计学习与符号推理的张力的(a)中生长出来的。数据提供广度,知识提供深度;学习提供适应性,推理提供可靠性。当二者真正在数学层面统一之日,或许就是人工智能从“工具”走向“智能”之时。